
Kullanılabilirlik Sorunlarında Şiddet Derecelendirmesi ve 0-4 Ölçeği
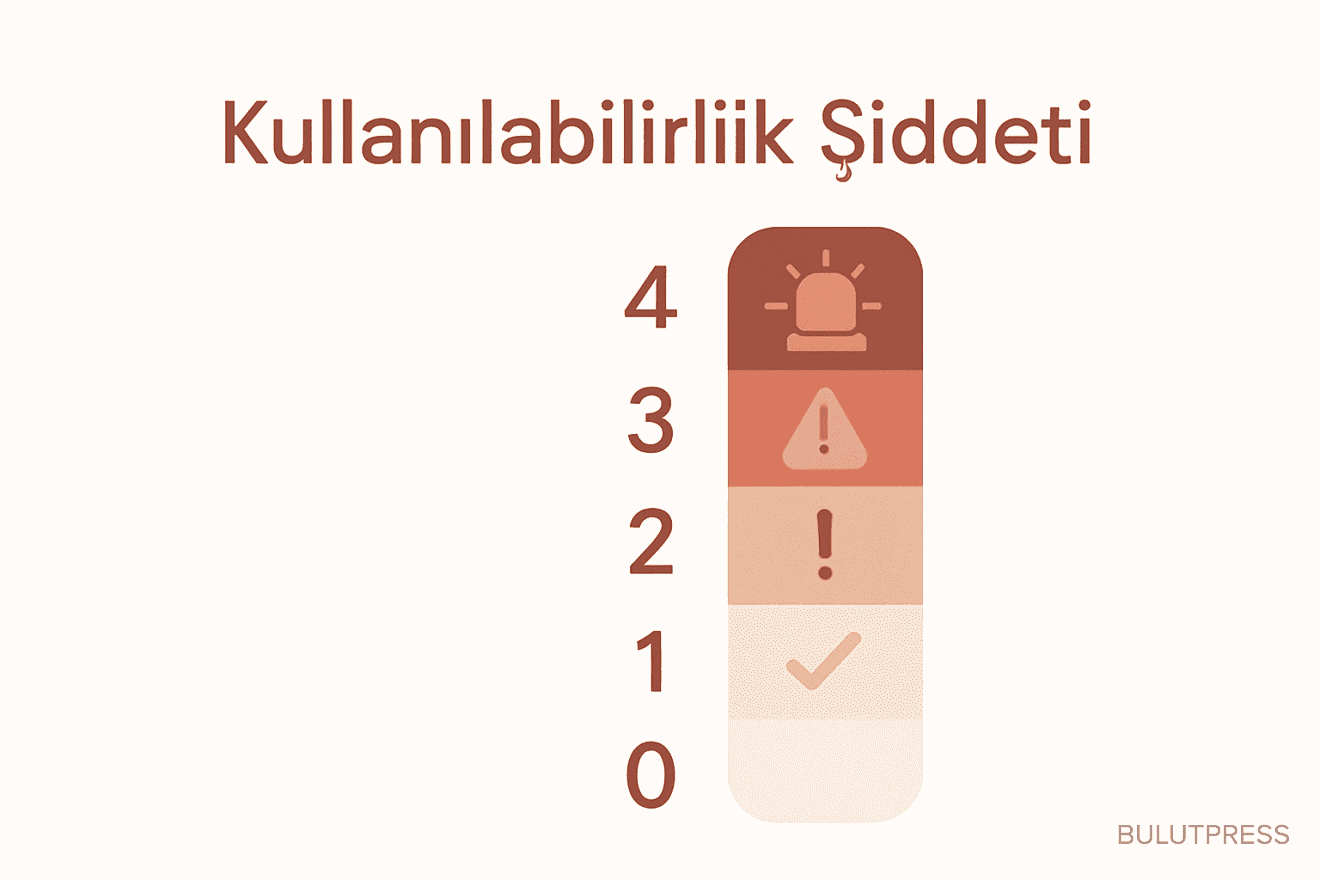
Elinizde otuz kullanılabilirlik bulgusu var, önünüzde iki haftalık bir sprint. Hepsi düzelmeyecek. Şiddet derecelendirmesi tam bu noktada işe yarar: her bulguya 0 ile 4 arasında bir puan verirsiniz, tartışma "bana göre şu daha önemli" olmaktan çıkıp puan üzerinden yürür.
Ölçek: 0'dan 4'e
Alanda yerleşik olan ölçek Nielsen'ın beşli skalası:
- 0 Sorun değil. Bulgu listeden düşer.
- 1 Kozmetik. Vakit kalırsa.
- 2 Minör. Kullanıcı yavaşlıyor ama yoluna devam ediyor.
- 3 Majör. Kullanıcı görevi zor tamamlıyor ya da yanlış tamamlıyor.
- 4 Felaket. Düzelmeden yayına çıkmaz.
Beş basamak var ama ölçek dört kademe taşıyor; 0 bir şiddet seviyesi değil, bulgunun iptali. Değerlendiricilerden birinin 0 vermesi hata sayılmaz, bilgi taşır: aynı ekrana bakan iki kişiden biri orada sorun görmüyorsa konuşulacak bir şey vardır.
Puanı üreten üç şey
Bir bulguya bakıp doğrudan "3" demek zordur. Üç soruyu ayrı ayrı cevaplayın, puan sonra gelsin:
- Frekans: kaç kullanıcı, kaç denemede takıldı?
- Etki: takılınca ne kaybediyor? Saniye mi, veri mi, güven mi?
- Kalıcılık: bir kez öğrenince aşıyor mu, yoksa her seferinde aynı yere mi çarpıyor?
Üçü çarpılıp tek sayıya indirgenmez, ağırlıkları eşit değil. Nadiren görülen ama veri kaybettiren bir hata, herkesin ilk seferde takıldığı ama ikinci seferde geçtiği bir yerleşim sorunundan daha yüksek puan almalı. Öğrenilebilir engel maliyeti bir kez öder; geri alınamayan kayıp her seferinde öder.
Ortalama puan neyi gizler
Üç uzmanın bağımsız puan verip ortalamasının alınması standart tavsiye. Mantıklı, ama ortalamanın kendisi bir şeyi yutuyor. 0 ve 4 veren iki değerlendirici ortalama 2 üretir. 2 ve 2 veren iki değerlendirici de ortalama 2 üretir. Tabloda aynı satır görünür, oysa biri üzerinde uzlaşılmış bir minör sorun, diğeri ekibin ikiye bölündüğü bir belirsizlik.
Ortalamayı sıralama için kullanın, etiket olarak değil. 2,7 diye bir şiddet seviyesi yok; o sayı bulguları alt alta dizmeye yarar, rapora "minör" ya da "majör" yazmaya değil. Yanına puanların aralığını da taşıyın. Aralık 2 puandan genişse ortalamaya bakmayı bırakıp değerlendiricileri aynı masaya oturtmak gerekir, çünkü orada tartışılan genelde sorunun şiddeti değil, sorunun ne olduğu.
Bir de şu ayrımı kaybetmeyin: bir bulguyu hiç fark etmemiş bir uzmanın verdiği 0 ile, görüp zararsız bulduğu 0 aynı şey değil. Birincisi ortalamayı sahte biçimde aşağı çeker. Formda "görmedim" için ayrı bir kutu bırakın ve o satırları ortalamaya katmayın.
Sıra yalnızca şiddetten çıkmaz
Şiddet listesi elinizde hazır olsa bile düzeltme sırası ondan ibaret değil. Bulgu tablosuna düzeltme maliyeti için ikinci bir sütun ekleyin; ikisini aynı ekranda görmeden verilen sıra kararı neredeyse her seferinde yanlış çıkıyor. Kozmetik diye 1 verdiğiniz hizalama hatası tek satır CSS ile kapanıyorsa onu sprint sonuna atmanın kimseye faydası yok. Buna karşılık 4 verdiğiniz veri kaybı hatası veri modeline dokunuyorsa, o bulgu tek başına bir sprint yer kaplar ve planı ona göre kurmanız gerekir.
Tek katı kural 4'lerde: onlar kapanmadan yayın açılmaz. Geri kalan her şey şiddet ile maliyetin birlikte okunduğu bir kuyruk.
Bulguyu nasıl yazdığınız puanı belirler
Kötü yazılmış bir bulgu tutarlı puan alamaz. "Filtre alanı kafa karıştırıyor" cümlesine üç kişi üç farklı sayı verir, çünkü üçü farklı şeyi puanlıyordur. Bulguyu ekran görüntüsü, kullanıcının izlediği adımlar, beklenen sonuç ve gözlenen sonuç ile yazın. Puanlama turundan önce herkes aynı metni okusun.
Sürüm başına bir kez tekrarlayın. Şiddet puanları arayüz değiştikçe eskir; altı ay önceki 3, bugünün akışında 1 olmuş olabilir.